Трекер онлайн, данные идут, в базе пусто: разбор фриза, который ничем себя не выдавал
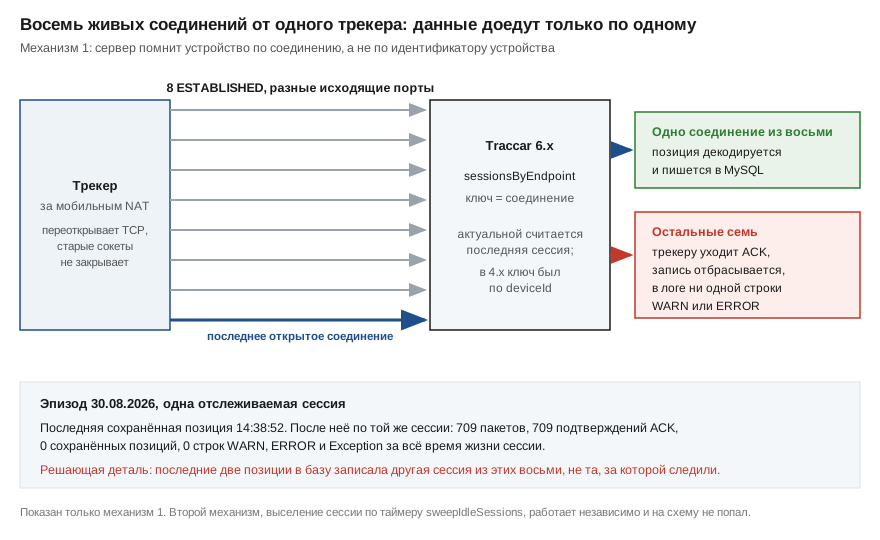
Самая неудобная авария, это та, которая ничего не ломает. 30 августа 2026 года наш сервер принял от одного трекера 709 пакетов подряд, подтвердил приём каждого и не сохранил ни одной позиции. Сайт отвечал 200, устройство числилось online, за всё время жизни сессии в логе не появилось ни строки уровня WARN или ERROR. Мониторинг молчал, потому что всё, за чем он следил, действительно было в порядке. Заметил владелец машины.
Ниже полная хронология разбора: четыре тупика, в которые мы заходили, патч в ConnectionManager, который убрал симптом на неделю, и то, чем эта история закончилась на самом деле. Спойлер: не победой. Через неделю выяснилось, что механизмов потери данных было два, а патч чинит только один.
как устроен наш GPS-мониторинг
Коротко о главном
- Симптом не подавал ни одного сигнала, за которым обычно следит мониторинг: сервис жив, сайт 200, устройство
online, лог чистый. Он молча перестал делать ровно одну вещь, писать позиции в базу.- Причина оказалась не в базе и не в нагрузке, а в том, по какому ключу сервер связывает пришедший пакет с устройством. Traccar 6.x держит сессию с ключом по соединению (
sessionsByEndpoint) и считает актуальным последнее открытое. Трекер за мобильным NAT переоткрывал TCP, не закрывая старые сокеты: мы видели восемь живых одновременно.- Самый опасный ложный след дала неверная команда.
ssна хосте показал ноль соединений, потому что Traccar в Docker. Изнутри контейнера их было восемь. Неверная команда вернула не пустой ответ, а уверенный неправильный.- Откат на старую версию ради «там этого бага не было» уронил сайт для всех пользователей: формат хеша пароля между 6.15 и 6.5 несовместим. Проверка отката на копии базы этого не предсказала, копия разошлась с продом по миграциям.
- Патч закрывает старый канал при появлении нового и держит число ESTABLISHED на 1-2. Но второй, независимый механизм (выселение сессии таймером
sweepIdleSessions) он не трогает вообще, и удерживается только конфигом.- «Починили, рецидивов нет» и «поняли причину» это не одно и то же. Неделя тишины едва не заставила нас откатить настройку, которая держала вторую половину проблемы.
О достоверности цифр в этом разборе. Часть чисел перепроверена в сохранённых артефактах эпизода: 709 пакетов, 0 сохранённых позиций, 0 строк
WARN/ERROR, 2256 строк лога сессии, показания дампа JVM, выводnetstat. Часть взята из рабочей записи того дня, и перепроверить её уже нельзя: исходныйtracker-server.logротировался. Это касается разбора «22 сессии за день, из них 8 не закрылись штатно». Мы оставляем эти числа в тексте, потому что они объясняют механизм, но помечаем прямо в том месте, где они появляются.
Как выглядел симптом: никак
Позиции трекера периодически переставали сохраняться в базу. При этом устройство было на связи и данные слало. Перезапуск Traccar помогал, но ненадолго.
Дальше начинается то, ради чего эту историю стоит рассказывать. Мониторинга на такое состояние у нас не было вообще. Grafana следила за диском, памятью и свопом. Uptime Kuma проверяла, что сайт отвечает 200. Обе системы говорили «всё хорошо», и обе были правы: сервер жив, места хватает, сайт работает, трекер числится на связи.
Вот как это выглядело изнутри, по сохранённому целиком логу одной TCP-сессии эпизода 30 августа (2256 строк):
- позиции писались в базу примерно каждые 30 секунд до 14:38:52;
- после этого на той же самой TCP-сессии сервер принял ещё 709 пакетов и подтвердил
ACKкаждый из них; - декодированных позиций из этих 709 пакетов: ноль;
- строк уровня
WARN,ERRORиExceptionза всё время жизни сессии: ноль.
Система не падает, не тормозит и не ругается. Она перестаёт делать одну вещь и никак об этом не сообщает.
Отдельная подлость: статус устройства в интерфейсе показывал online, и это было формально правдой. В разгар расследования мы задрали status.timeout до 30 суток, а при таком значении молчащий трекер месяц числится на связи. Как индикатор здоровья статус в этой конфигурации бесполезен, о чём ниже будет отдельный разговор.
почему трекер показывает движение при потерянном GPS
Четыре ложных следа
Дальше по порядку, тем же маршрутом, которым шли сами. Тупики здесь полезнее выводов: каждый из них выглядел логично в момент, когда в него сворачивали.
След №1: «трекер вообще не подключён»
Первая проверка была самой очевидной. Смотрим с хоста, есть ли живые соединения на порту протокола:
ss -tnp | grep ':5162' | grep '<адрес трекера>'   → пусто
ss -tn  | grep -c ':5162'                          → 0
Ноль. Вывод напрашивался сам: устройство отвалилось, сервер ни при чём, чинить на нашей стороне нечего.
Вывод был неверным. Traccar работает в Docker, и клиентские соединения живут в сетевом пространстве контейнера, а не хоста. ss на хосте их не видит и честно сообщает то, что видит, то есть ничего. Правильный вопрос выглядит так:
docker exec <контейнер> netstat -tn | grep :5162
Ответ: восемь строк ESTABLISHED с одного адреса, разные исходящие порты.
Это самый ценный кусок всей истории, и он не про Traccar. Неверная команда дала не пустой результат и не ошибку, она дала уверенный неправильный ответ. Пустой вывод ss невозможно отличить от настоящего отсутствия соединений, у него нет никакого признака «я смотрю не туда». Ошибка, которая падает, стоит десять минут. Ошибка, которая отвечает уверенно и неправильно, стоит полдня и уводит расследование в сторону.
След №2: утечка памяти или GC-спираль
Вторая версия классическая: JVM задыхается, сборщик мусора съел процессор, поток обработки не успевает, данные теряются.
Проверять её решили дампом, а не рестартом:
kill -3 <pid>
Результат закрыл гипотезу за минуту:
garbage-first heap total 1048576K, used 143530K
Занято 13,7 % кучи, сборщику почти нечего делать. Потоков 43: 19 в RUNNABLE, 14 в TIMED_WAITING, 1 в WAITING, ни одного BLOCKED, дедлоков нет. JVM была абсолютно здорова.
Здесь важен не сам вывод, а выбор инструмента. kill -3 печатает дамп потоков и краткую сводку по куче в стандартный вывод процесса и при этом ничего не перезапускает. Рестарт Traccar «вылечил бы» симптом на несколько часов и одновременно стёр бы все улики: живые сокеты, состояние сессий, содержимое кучи. Мы бы получили работающий сервис и ноль информации о том, что с ним было.
Правило, которое из этого выросло: на воспроизводимом симптоме сначала снимается состояние, потом делается рестарт. В обратном порядке расследование не начинается никогда, потому что после рестарта расследовать нечего.
След №3: сессию выселили по таймауту
Третья версия: сервер сам забыл про устройство, потому что долго не получал от него валидных данных, и после этого пакеты стало не к чему привязывать.
Проверили статус устройства в базе. online, сессия не выселена. Версия отпала.
И вот здесь интересное. Версия отпала правильно: для того конкретного эпизода она была неверной. Но мусором она не оказалась. Через неделю выяснилось, что это второй, полностью независимый механизм ровно того же симптома, и что от первого он не лечится. Версия была верной вообще, но неверной для эпизода, который мы разбирали. Отличить одно от другого в тот момент было невозможно.
След №4, самый дорогой: «это регресс версии, откатимся»
Четвёртая версия звучала разумно: раньше такого не было, значит, что-то сломали в новой версии, откатимся на старую и посмотрим.
Откатились с 6.15 на 6.5. Через несколько минут сайт лёг для всех пользователей: /api/devices отвечал 400 на каждый запрос.
Illegal hexadecimal character P at index 0 - DecoderException
    (... DataConverter < Hashing < User < LoginService ...)
Формат хранения хеша пароля между этими версиями несовместим. 6.15 пишет хеш с префиксом алгоритма, LoginService из 6.5 ожидает чистый hex и падает на любой попытке аутентификации, у всех пользователей сразу. Вернули тег обратно, простой составил единицы минут.
Мораль здесь не «не откатывайтесь», а более узкая: откат версии это не бесплатная операция и не нейтральное диагностическое действие. Он меняет контракт с данными, которые уже лежат в базе, и меняет молча, потому что схема при этом формально совместима.
Отдельно про то, почему нас не спасла подготовка. Откат проверялся на копии базы, и там всё поднялось. Копия разошлась с продом по истории миграций, и именно тот участок, на котором сломалась аутентификация, на копии выглядел иначе. Проверка на несинхронной копии даёт ложное чувство подстрахованности, которое хуже отсутствия проверки: без неё откат делали бы осторожнее.
Сводка по тупикам
| Версия | Почему выглядела убедительно | Чем закрыта | Что осталось полезного |
|---|---|---|---|
| Трекер отключился | ss на хосте показал 0 соединений |
netstat из контейнера: 8 ESTABLISHED |
Проверять сеть в том же пространстве имён, где живёт сервис |
| Утечка памяти, GC | Симптом похож на «сервис задыхается» | kill -3: куча занята на 13,7 %, ни одного BLOCKED |
Снимать состояние до рестарта, а не после |
| Сессию выселили по таймауту | Механизм существует и правдоподобен | Статус в базе online, сессия жива |
Версия вернулась через неделю как второй механизм |
| Регресс версии | «Раньше не было, значит сломали» | Откат уронил аутентификацию у всех | Откат меняет контракт с данными, тестовая копия должна совпадать с продом по миграциям |
Почему мы почти не думали на базу и на нагрузку
Скажем честно: почти не думали, и это оказалось правильным решением по случайности, а не по проницательности. Довод появился только в конце разбора.
Довод такой: во время фриза другая сессия того же устройства писала позиции в ту же самую MySQL. База принимала записи в тот самый момент, когда «данные не сохранялись». Доказательство лежало прямо в данных, и найти его можно было в первые полчаса, если бы мы догадались его поискать.
Про нагрузку тоже стоит сказать прямо, потому что соблазн связать сюжеты был. Машина маленькая, 2 vCPU и 3,8 ГиБ, и проблемы с памятью на ней действительно были: своп забивался из-за двух JVM и роя процессов docker-proxy при пробросе трёх сотен портов. Но это отдельная история, которая случилась позже и к фризу отношения не имеет. Мы специально не сшиваем два сюжета в один: получилась бы красивая и ложная причинно-следственная связь, а из неё, скорее всего, выросло бы неверное лечение.
Настоящая причина: сервер помнит устройство по соединению
Мобильный модем трекера за NAT переоткрывает TCP-соединения и не закрывает старые. Накапливается несколько живых сокетов от одного устройства, в нашем случае до восьми одновременно.
Traccar 6.x привязывает устройство к последней сессии: карта sessionsByEndpoint ключуется по соединению. Пакеты, прилетающие по старым, но всё ещё живым соединениям, молча теряются. Трекеру при этом уходит подтверждение приёма, а в базу не попадает ничего. Это регрессия относительно ветки 4.x, где активная сессия хранилась по deviceId в структуре activeDevices, то есть привязка шла к устройству, а не к каналу.
Диагноз собрался из трёх наблюдений, и все три сделаны на живом зависшем состоянии, а не по логам постфактум:
kill -3показал, что JVM здорова: ни GC, ни дедлока.netstatиз контейнера показал восемьESTABLISHEDна порт протокола с одного адреса.- Позиции оборвались резко, а не «поредели». В том эпизоде их 142, медианный интервал 30 секунд, и ритм держался таким до последней записи: последние двенадцать интервалов 26, 26, 30, 30, 35, 25, 30, 30, 40, 19, 30, 32 секунды, дальше пусто.
Третье наблюдение диагностично само по себе, и стоит объяснить, почему. Если бы данные редели постепенно, это указывало бы на деградацию: растущую нагрузку, сборку мусора, забитую очередь. Мгновенная остановка при ровном ритме означает другое — обрабатывать перестали не медленнее, а вообще. Ломается не производительность, а связь пакета с устройством.
Решающая деталь нашлась при разборе лога: последние две сохранённые позиции записала другая сессия, не та, за которой мы следили. В логе за день насчитали 22 сессии, каждая со своей идентификацией одного и того же устройства, и 8 из них никогда не закрывались штатно, что ровно совпало с восемью ESTABLISHED.
Эти два числа, 22 сессии и 8 незакрытых, взяты из рабочей записи того дня. Исходный
tracker-server.logс тех пор ротировался, и перепроверить их сейчас нельзя. Число «8» независимо подтверждается сохранённым выводомnetstat, число «22» не подтверждается ничем, кроме той записи.
Стоит подчеркнуть, насколько неинтуитивно это место. Симптом «сервис не пишет данные» инстинктивно ведёт в сторону базы, диска, нагрузки или очередей. Причина же была в том, по какому ключу сервер помнит устройство. Ни одна из привычных метрик такого не показывает, потому что с точки зрения всех метрик система работает нормально: пакет принят, обработан, ответ отправлен.
Патч и что он на самом деле закрывает
Правка маленькая. В ConnectionManager.getDeviceSession, в блоке if (oldSession != null), сразу после чистки endpoint:
Channel oldChannel = oldSession.getChannel();
if (oldChannel != null && oldChannel != channel && oldChannel.isOpen()) {
    oldChannel.close();
}
Смысл: если устройство пришло по новому каналу, а старый канал всё ещё открыт, старый закрывается принудительно. Зомби перестают накапливаться.
Результат на проде: число ESTABLISHED от адреса трекера держится на 1-2, изредка мелькает FIN_WAIT2. Второе как раз и есть видимая работа патча, состояние закрывающегося старого сокета.
Наблюдение вели вручную, три проверки за ночь примерно раз в три часа: в 23:43, 02:43 и 05:43 МСК. Смотрели одно и то же:
- число соединений на порту протокола от адреса трекера;
- свежесть последней позиции в базе;
- отвечает ли сайт 200.
На проверке в 02:43 попали ровно на момент, когда патч штатно закрывал старое соединение: в выводе висел FIN_WAIT2. Это прямое подтверждение, что работает заявленный механизм, а не «само прошло», и такое подтверждение дороже суток тишины.
Итог первой ночи: около 12 часов без рецидива, дальше неделя. Перед патчем мы включили logger.level=all, чтобы поймать следующий эпизод в подробностях. Не понадобилось: причину подтвердили разбором TCP-сессий, и подробное логирование выключили обратно.
Насчёт судьбы патча стоит быть точным, потому что тут легко сказать красиво и неверно.
Временной мы считаем только эту половину — фикс с закрытием старого канала. Если в основной ветке появится своё решение, от нашего мы откажемся с удовольствием. Но наш образ собран из двух патчей, и второй, разбор субрекордов датчиков EGTS, временным не является вовсе: на нём держатся все каналы телеметрии, от зажигания и двери до уровня топлива. Возврат на официальный образ означал бы потерю датчиков, так что «когда починят, вернёмся на официальный образ» было бы неправдой.
Своей задачи в апстрим мы пока не заводили. В трекере проекта есть отчёты о похожих симптомах, но нашего механизма — старое живое соединение, продолжающее принимать и подтверждать трафик, — в них не описано. Пока мы не оформили воспроизведение, ссылаться на чужие задачи как на «нашу» было бы натяжкой.
Через неделю: механизм оказался не один
Здесь история перестаёт быть историей успеха.
Неделя без рецидивов расслабила. Владелец задал вопрос из чистого любопытства: раз патч живёт неделю и всё хорошо, можно вернуть status.timeout к обычным десяти минутам? В разгар расследования мы задрали его до 30 суток (status.timeout=2592000) и с тех пор к настройке не возвращались.
Пошли смотреть исходники, чтобы ответить уверенно. И выяснили, что механизмов потери данных два, а патч закрывает только первый.
Второй работает так. ConnectionManager.sweepIdleSessions() раз в минуту вызывает removeDeviceSession() для устройств, по которым дольше status.timeout не было валидной позиции. Канал при этом живой, переподключения не было, трекер продолжает слать пакеты. Но сессия выселена, а декодер EGTS ищет устройство только по сессии канала, без запасного пути по идентификатору объекта из самого пакета. Пришедшие координаты не к чему привязать, и данные молча теряются до следующего реального переподключения.
Патч по этому пути не делает ничего. Он срабатывает только при обнаружении нового канала у уже известного устройства, а sweep это отдельный таймер, вообще не завязанный на переподключение.
| Механизм 1: зомби-соединения | Механизм 2: выселение по таймеру | |
|---|---|---|
| Что происходит | Устройство привязано к последнему открытому каналу, старые живые каналы игнорируются | Сессия удаляется по status.timeout, живой канал остаётся без привязки к устройству |
| Триггер | Переоткрытие TCP трекером за NAT | Пауза между валидными фиксами дольше таймаута |
| Чем закрыт | Патч в ConnectionManager.getDeviceSession |
Конфиг status.timeout=2592000 |
| Симптом снаружи | Идентичный: пакеты идут, ACK уходит, позиций нет | Идентичный |
Два разных лекарства от неотличимых снаружи симптомов. И один из них, конфиг, мы едва не отменили, потому что неделя тишины выглядела как доказательство, что проблема решена.
Решение от 6 сентября: таймаут не возвращаем
Мы оставили status.timeout равным 30 суткам и возвращать к десяти минутам не будем.
Причина конкретная, а не «на всякий случай». EGTS-трекер на стоянке легко даёт паузы между валидными фиксами дольше десяти минут, это его нормальное поведение, а не сбой. Вернуть настройку к прежнему значению означало бы своими руками воспроизвести тот же фриз.
Ради чего вообще возвращать? Ради того, чтобы поле status в таблице устройств Traccar снова стало честным. Но это поле не видит ни один пользователь: наш сервис считает связность самостоятельно, по свежести последней позиции. Красивая внутренняя цифра, которую никто не читает, не стоит потерянных данных.
Оговорка обязательная: это не универсальный совет. Тридцатисуточный таймаут лечит конкретный путь потери данных ценой честности внутреннего статуса. Тому, кто на это поле опирается (например, строит по нему алерты или показывает его пользователям), нужно другое решение, скорее всего на уровне кода декодера, чтобы устройство находилось по идентификатору из пакета, а не только по сессии канала.
какие приборы и протоколы мы поддерживаем
Что появилось в мониторинге после разбора
Главный вывод для эксплуатации: если бы алерт существовал, владельцу не пришлось бы замечать проблему самому. Мы следили за ресурсами и доступностью сайта, а не за тем, ради чего сервис существует, то есть за поступлением данных.
Что завели:
Ops-алерт на фриз. Не клиентский, в Telegram админам. Порог: 30 минут без новых позиций по устройству. Протокол osmand из проверки исключён, потому что телефонные приложения штатно молчат сутками и завалили бы канал ложными срабатываниями.
Ориентир нормы для этого трекера. 150-290 точек в час, максимальный разрыв за сутки около пяти минут. Без такого ориентира любой порог берётся с потолка, и первым же делом его начинают двигать, чтобы «не спамило».
Число ESTABLISHED от адреса трекера как признак рецидива. Норма 1-2, рост к восьми это тревога. Метрика узкая и не годится как общий алерт, но для конкретно этого класса проблем она прямее всего.
И одна грабля рядом, на которую мы наступили при проверке соединений: нельзя фильтровать вывод по признаку «не наша подсеть». Собственный адрес контейнера выглядит как внутренний, и такой фильтр прячет ровно то живое соединение трекера, которое вы ищете. Фильтровать нужно по порту протокола.
Проверка здорового состояния сейчас выглядит так:
docker exec <контейнер> netstat -tn | grep :5162 | grep ESTABLISHED
→ ровно 1 соединение (во время фриза было 8)
Чего мы не знаем и не утверждаем
Что это баг всех версий Traccar. Мы видели проблему на ветке 6.x. Целенаправленно проверять, воспроизводится ли она в 6.15, мы не стали, задачи в апстрим не заводили, и до нормального воспроизведения рамки бага считать установленными нельзя.
Что виноват трекер. Он ведёт себя как обычный прибор за мобильным NAT: переоткрывает соединение, когда оператор роняет старое, и не тратит трафик на аккуратное закрытие. Ничего экзотического в его поведении нет, и менять устройство бессмысленно.
Что status.timeout в 30 суток это универсальный совет. Это лечение одного конкретного пути потери данных ценой честности внутреннего статуса. Подходит только тем, кто это поле не использует.
Что восемь соединений и рост интервала это типичная картина. Наблюдение сделано на одном устройстве. Статистики по парку у нас нет, и переносить числа на другие приборы или на протокол в целом было бы неправильно.
Что причина понята полностью. Первый механизм подтверждён кодом и наблюдением за поведением сокетов после патча. Второй разобран по исходникам, но воспроизводить его специально мы не стали: для этого пришлось бы вернуть короткий таймаут на проде и подождать фриза. Это разбор кода, а не эксперимент, и разница здесь существенная.
Частые вопросы
Почему ss на хосте не показывает соединения контейнеризованного сервиса?
Потому что контейнер живёт в своём сетевом пространстве имён, и таблица соединений у него собственная. ss на хосте честно показывает соединения хоста, среди которых клиентских сокетов контейнера нет. Опасность в том, что ответ выглядит как полноценный: пустой список неотличим от настоящего отсутствия подключений. Спрашивать нужно изнутри: docker exec <контейнер> netstat -tn или nsenter в пространство имён процесса.
Почему сервер отвечает трекеру ACK, если запись он не сохранил?
Это два разных уровня. ACK в протоколе подтверждает, что пакет принят и разобран транспортно, а не что позиция дошла до базы. В разобранном случае пакет действительно принимался корректно, отваливалась связка «этот пакет принадлежит вот этому устройству». С точки зрения трекера всё прошло успешно, и повторной отправки он не делает.
Почему перезапуск помогал, но ненадолго? Рестарт рвёт все накопившиеся соединения, трекер переподключается, и первая же новая сессия становится актуальной. Данные снова пишутся до тех пор, пока модем опять не начнёт переоткрывать TCP поверх старых сокетов. Именно поэтому рестарт здесь худший из возможных первых шагов: он даёт видимость починки и уничтожает состояние, по которому можно найти причину.
Как отличить этот фриз от обычной потери связи или пропажи GPS? По тому, идёт ли трафик. При потере связи соединений нет и пакеты не приходят. При потере спутников пакеты приходят, но в них нет навигационной части, и это отдельный сюжет со своими признаками. При описанном фризе пакеты приходят, они полноценные, а строк в базе не появляется. Проверяется сравнением счётчика принятых пакетов со счётчиком сохранённых позиций за тот же интервал. разбор случая, когда трекер на связи, а координат нет
Стоит ли ставить алерт на статус устройства в Traccar?
В нашей конфигурации нет, и это следствие принятого решения. При status.timeout в 30 суток поле status перестаёт нести информацию о связности: молчащее устройство месяц числится online. Мы считаем связность отдельно, по свежести последней позиции, и алерты строим на ней.
Почему откат версии оказался опаснее самого бага?
Потому что баг терял данные одного устройства, а откат сломал аутентификацию у всех пользователей сразу. Формат хеша пароля между версиями оказался несовместимым, и LoginService старой версии падал на любом входе. Схема базы при этом выглядела совместимой, никакой миграции «вниз» не требовалось, так что предупреждения не было ниоткуда.
Вывод
Две мысли из этой истории не про Traccar.
Первая: «починили, рецидивов нет» и «поняли причину» это разные утверждения, и второе из первого не следует. Неделя без симптома успокоила нас настолько, что мы едва не откатили конфиг, который в это время в одиночку держал вторую половину проблемы. Спас случайный вопрос владельца, заданный из любопытства, а не процесс и не проверка. Это неприятный вывод, и именно поэтому его стоит записать.
Вторая: симптом «данные не сохраняются» почти рефлекторно уводит в сторону базы и нагрузки. В обоих механизмах причина была в одном и том же месте, в том, как сервер связывает пришедший пакет с устройством: сначала по последнему соединению, потом по сессии, которую он же сам и выселил по таймеру. База при этом работала безупречно и во время фриза принимала записи от другой сессии того же устройства.
Практический следующий шаг, если вы держите свой сервер мониторинга: проверьте, есть ли у вас алерт на отсутствие новых позиций при живом соединении. Не на доступность сервиса, не на ресурсы, а именно на то, ради чего сервис работает. Мы такого алерта не имели и узнали о проблеме от пользователя.
Материал подготовлен на данных сервиса мониторинга «Точка GPS»: артефакты инцидента 30 августа - 6 сентября 2026 года на рабочем сервере, сохранённый лог TCP-сессии, дамп JVM, разбор исходников Traccar 6.x и собственный патч.